APIリファレンス
はじめに
akaBot Vision API を使用すると、組織のデータとアカウント情報にプログラムでアクセスして管理できます。
このドキュメントでは、開発者の観点から API の使用法を紹介し、すべての API オブジェクトとメソッドへのリファレンスを示します。
akaBot Vision の API はどのように機能しますか?
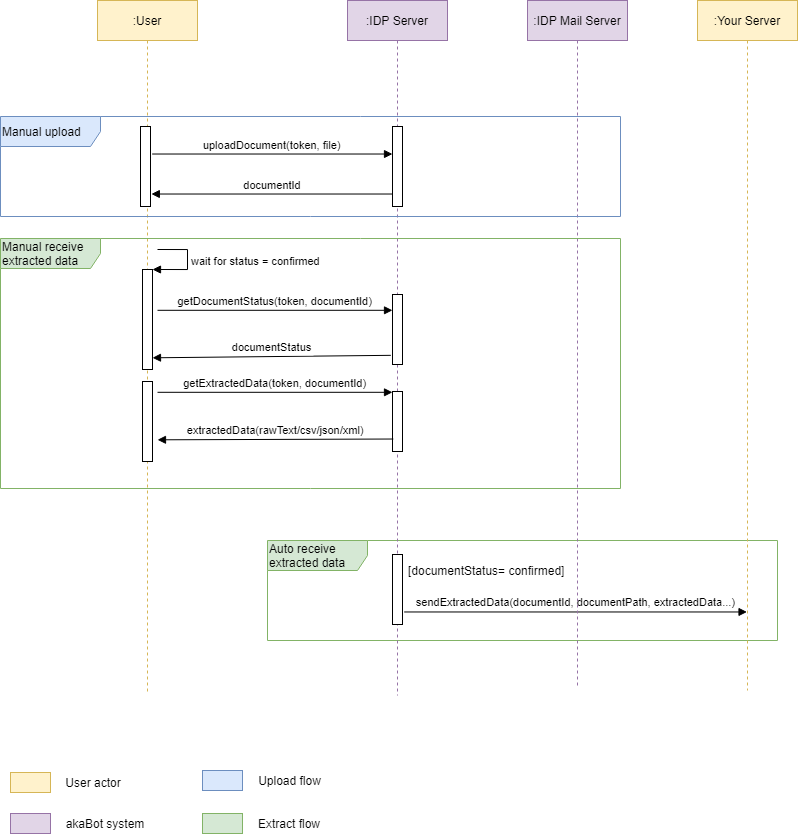
a.ドキュメントのインポート
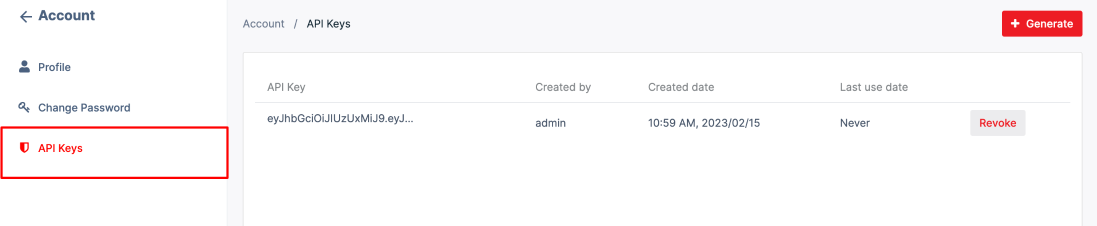
ユーザーは akaBot Vision にログインして、最初にユーザーのプロフィール セクションの下にあるアカウント セクションの API キーのトークンを取得する必要があります。
その後、ユーザーはAPI Import Documentを呼び出し、リクエスト情報 (トークンとファイルをアップロードする必要がある) を IDP サーバーに送信することでドキュメントを手動でアップロードできます。その後、IDP サーバーは documentId とドキュメントのステータス「インポート中」をユーザーに応答します。ドキュメントのサイズによっては、IDP サーバーがドキュメントを処理するのに 2 ~ 3 分かかる場合があります。
b.ドキュメントステータスの取得
処理時間が経過した後、ユーザーは APIGet Document Statusを呼び出してドキュメントのステータスを再確認します。リクエスト情報は、APIImport Documentを介して応答された documentId です。
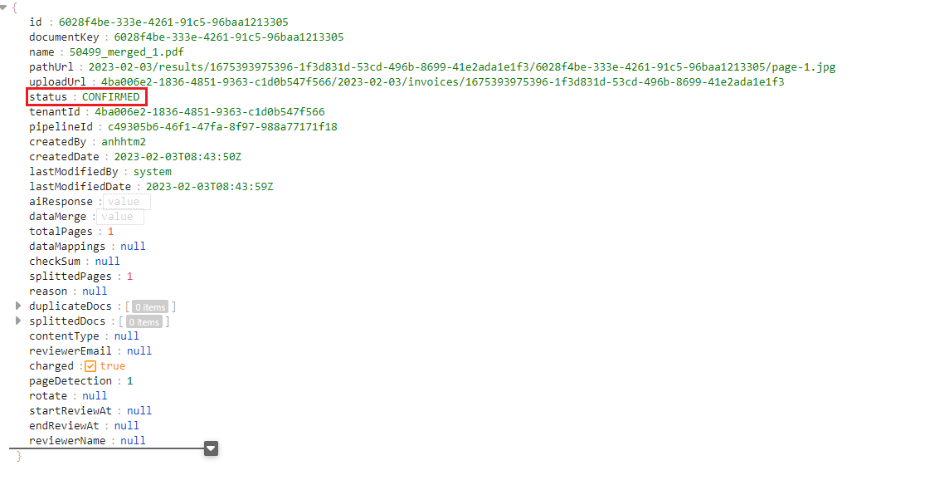
- ドキュメントのステータスが「確認済み」の場合、このドキュメントは正常に処理され、ユーザーは入力パラメータ (Id およびexportType) を指定して APIExport Documentを呼び出すことでデータをエクスポートできることを意味します。
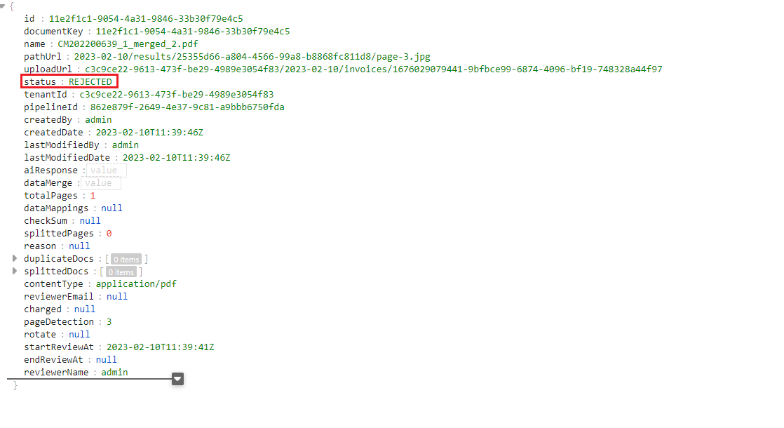
- ドキュメントのステータスが「拒否」になっている場合は、IDP がこのドキュメントが請求書ではないことを検出し、拒否したことを意味します。
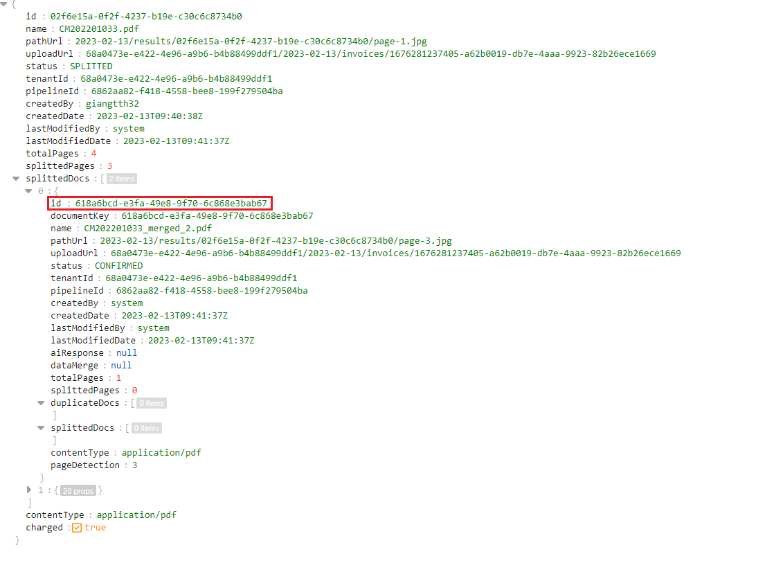
- ドキュメントのステータスが「分割」で、分割されたドキュメントが空でない場合は、このドキュメントに複数のページがあり、IDP が自動的に子ドキュメントに分割されていることを意味します。ユーザーは親 ID を使用して分割ドキュメントをマッピングできます
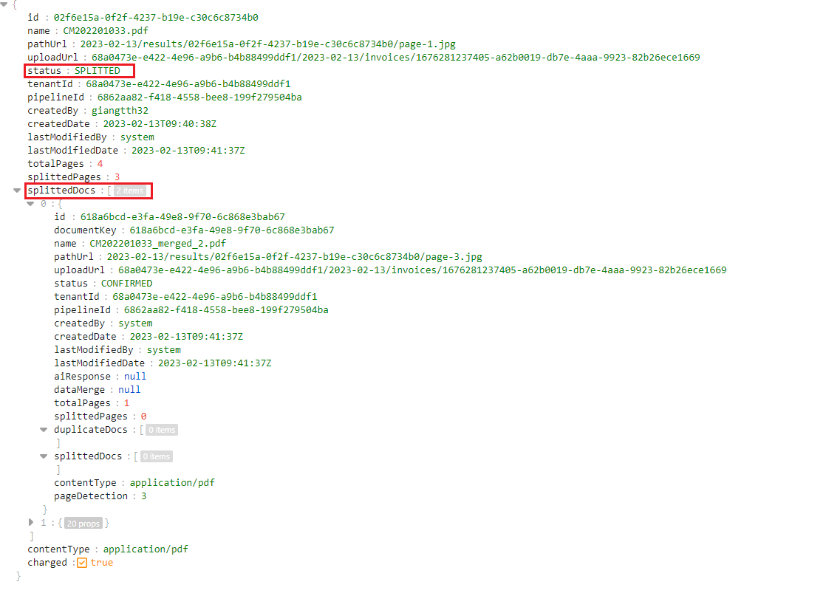
- 現時点では、ユーザーは、splittedDocs で応答された documentId の APIGet Document Statusを呼び出すことで子ドキュメントのステータスを確認し、APIExport Documentを呼び出すことによって、splittedDocs の「確認済み」ドキュメントをエクスポートできます。
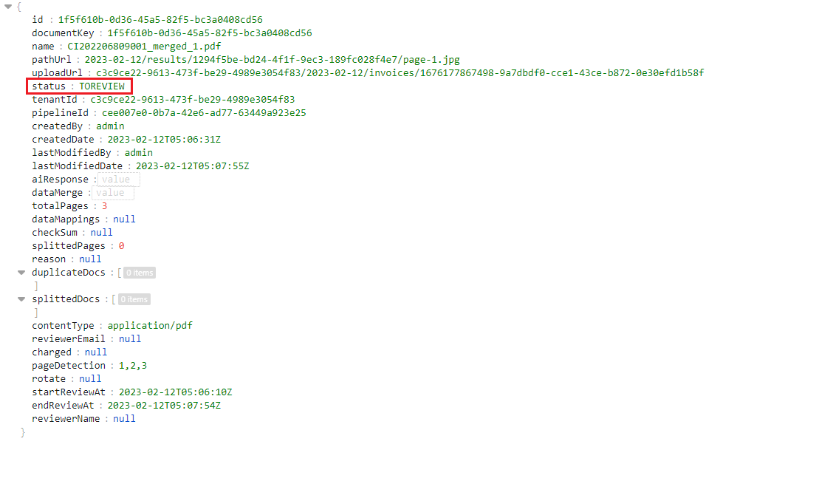
- ドキュメントのステータスが「レビュー中」の場合、ユーザーはドキュメントをレビューし、データをエクスポートする前に APIUpdate Document Statusによってドキュメントを「確認済み」ステータスに変更する必要があることを意味します。
c.ドキュメントの取得
ユーザーが特定のステータスを持つすべてのドキュメントのリストを取得したい場合は、APIGet Documentsを呼び出すことができます。
d.ドキュメントのエクスポート
ユーザーは、ドキュメントが「確認済み」ステータスに変更されるのを待ち、入力パラメーター (トークン、抽出する必要がある documentId、およびユーザーがエクスポートしたいファイル形式) を使用して IDP サーバーにAPI Export Documentを呼び出して、抽出されたデータ情報を取得する必要があります。その後、API Export Documentは、選択した形式で抽出されたデータをユーザーに応答します。
API サンプルは、以下の API 詳細に従います。
APIの詳細
1. ドキュメントのインポート
- 目的: REST API を使用してドキュメントを akaBot Vision にインポートできます。サポートされているファイル形式は PDF、PNG、JPEG です。
- URL:
{serverEndpoint}/api/uploadFile/{pipelineId} - Content-Type: multipart/form-data
- メソッド: POST
- リクエストヘッダー:
Authorization: Bearer {apiKey} - 入力本文:
| 属性 | タイプ | 説明 | 必須 |
| パイプラインID | 文字列 | パイプラインのID | はい |
| ファイル | フォームデータ | アップロードするドキュメントをリストする | はい |
- 応答:
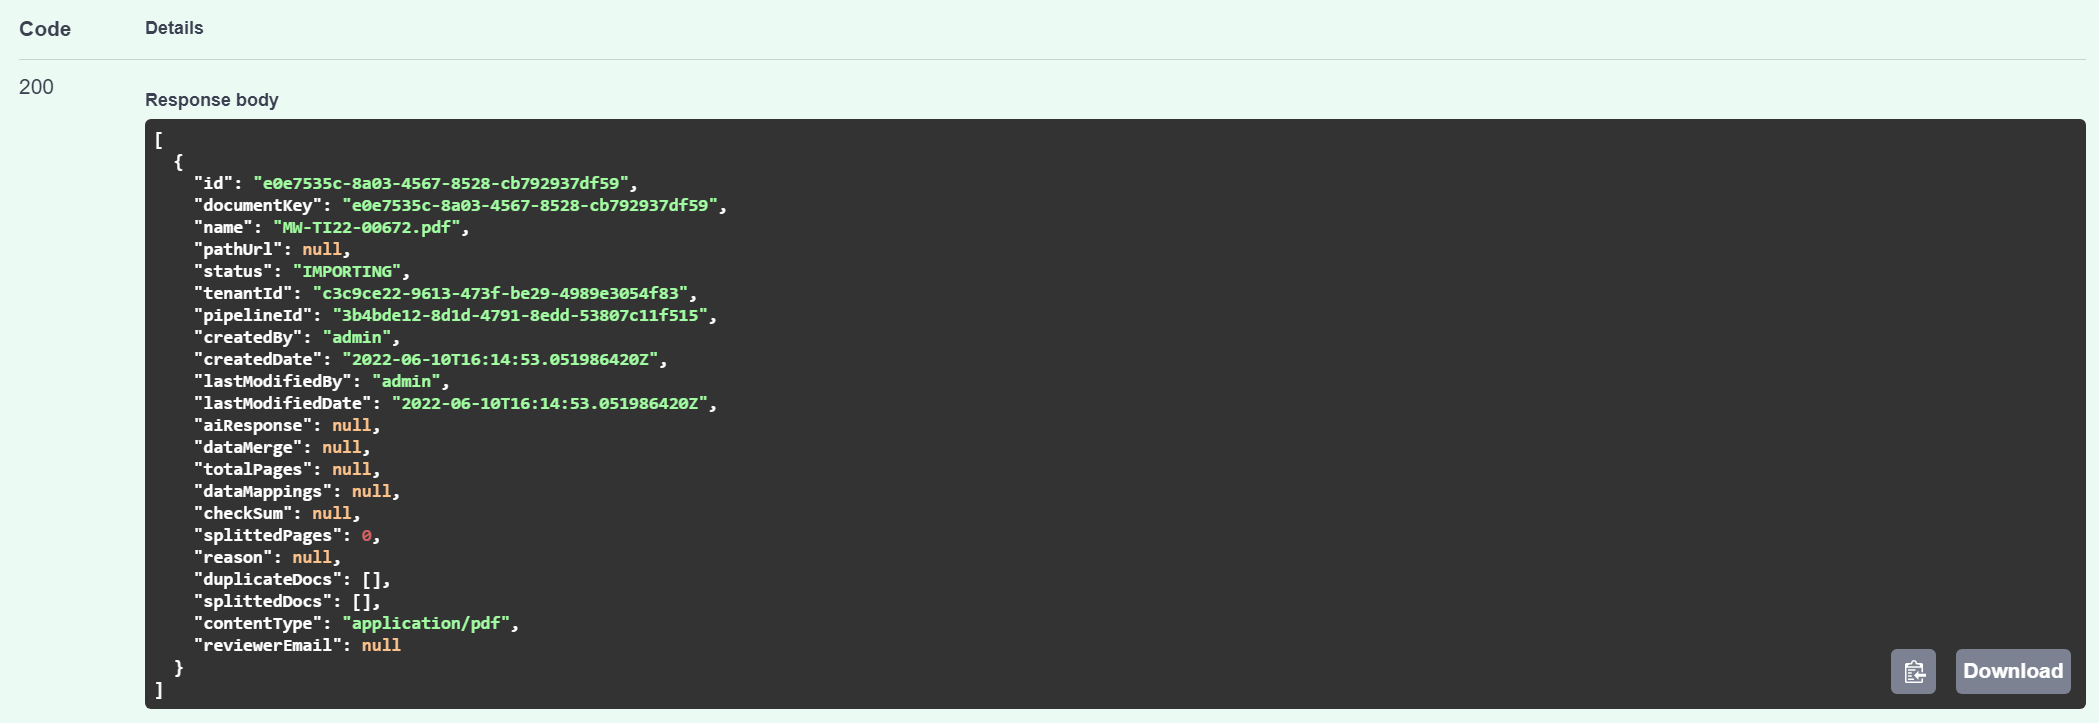
成功するとコード 200 が返され、応答はドキュメント モデル配列になります。
失敗した場合は、以下のエラーコードとメッセージコードを返します。
| 応答コード | 説明 |
| 200 | OK |
| 201 | 作成されました |
| 401 | 無許可 |
| 403 | 禁止 |
| 404 | 見つかりません |
応答例:
2. ドキュメントのエクスポート
- 用途:確認後のドキュメントはAPIエクスポートドキュメント経由でcsv,json,xlxs,xmlファイルにエクスポート可能
- URL:
{serverEndpoint}/api/export-documents/{id}?exportType={exportType} - コンテンツタイプ: application/json
- メソッド: GET
- リクエストヘッダー:
Authorization: Bearer {apiKey} - 入力パラメータ:
| 属性 | タイプ | 説明 | 必須 |
| ID | 文字列 | ドキュメント ID がエクスポート データを必要としています | はい |
| エクスポートタイプ | 文字列 | ユーザーがエクスポートしたいファイル形式 * csv * xlxs * xml * json | はい |
- 出力
- 成功すると、コード 200 と入力タイプのファイルが返されます。
- 失敗した場合は、以下のエラーコードとメッセージコードを返します。
| 応答コード | 説明 |
| 200 | OK |
| 401 | 無許可 |
| 403 | 禁止 |
| 404 | 見つかりません |
応答例:
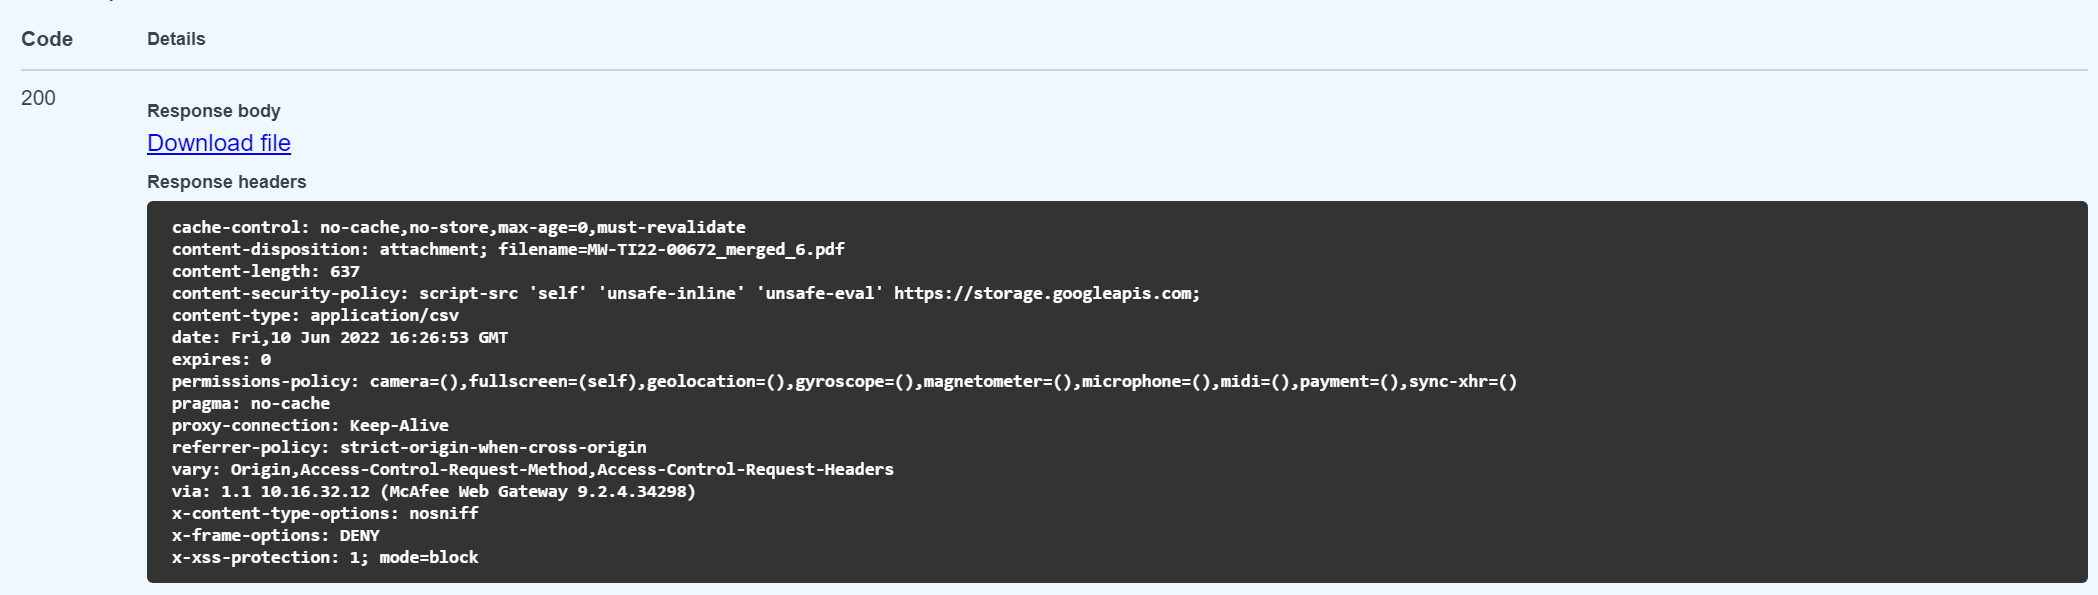
3. 書類を入手する
- 目的: 特定のステータス (IMPORTING、TOREVIEW、CONFIRMED、EXPORTED、DELETED、REJECTED) を持つ特定のパイプラインのリスト ドキュメントを取得できます。ユーザーがステータスを API に送信しない場合、API はすべてのステータスを含むドキュメントのリストを応答します。
- URL:
{serverEndpoint}/api/documents?page={page}&size={size}&status={status}&pipelineId={pipelineId}&documentName={documentName}&dateFrom={dateFrom}&dateTo={dateTo}&sort=createdDate,desc - コンテンツタイプ: application/json
- メソッド: GET
- リクエストヘッダー:
Authorization: Bearer {apiKey} - 入力パラメータ:
| 属性 | タイプ | 説明 | 必須 |
| ページ | 整数 | 要求されたページのページ番号 | いいえ |
| サイズ | 整数 | ページのサイズ | いいえ |
| 並べ替える | 文字列 | 形式の並べ替え基準: property(,asc | 説明)。デフォルトの並べ替え順序は昇順です。 |
| ステータス | 文字列 | 文書のステータス (インポート中、レビュー中、確認済み、エクスポート済み、削除済み、拒否済み) | いいえ |
| パイプラインID | 文字列 | パイプラインの ID | はい |
| 文書名 | 文字列 | 入力値を含むドキュメント名の検索 | いいえ |
| 日付から | 整数 | 文書を日付から並べ替える | いいえ |
| 日付まで | 整数 | 文書を日付までに並べ替える | いいえ |
- 出力
成功するとコード 200 が返され、応答はドキュメント モデル配列になります。
失敗した場合は、以下のエラーコードとメッセージコードを返します。
| 応答コード | 説明 |
| 200 | OK |
| 401 | 無許可 |
| 403 | 禁止 |
| 404 | 見つかりません |
応答例:
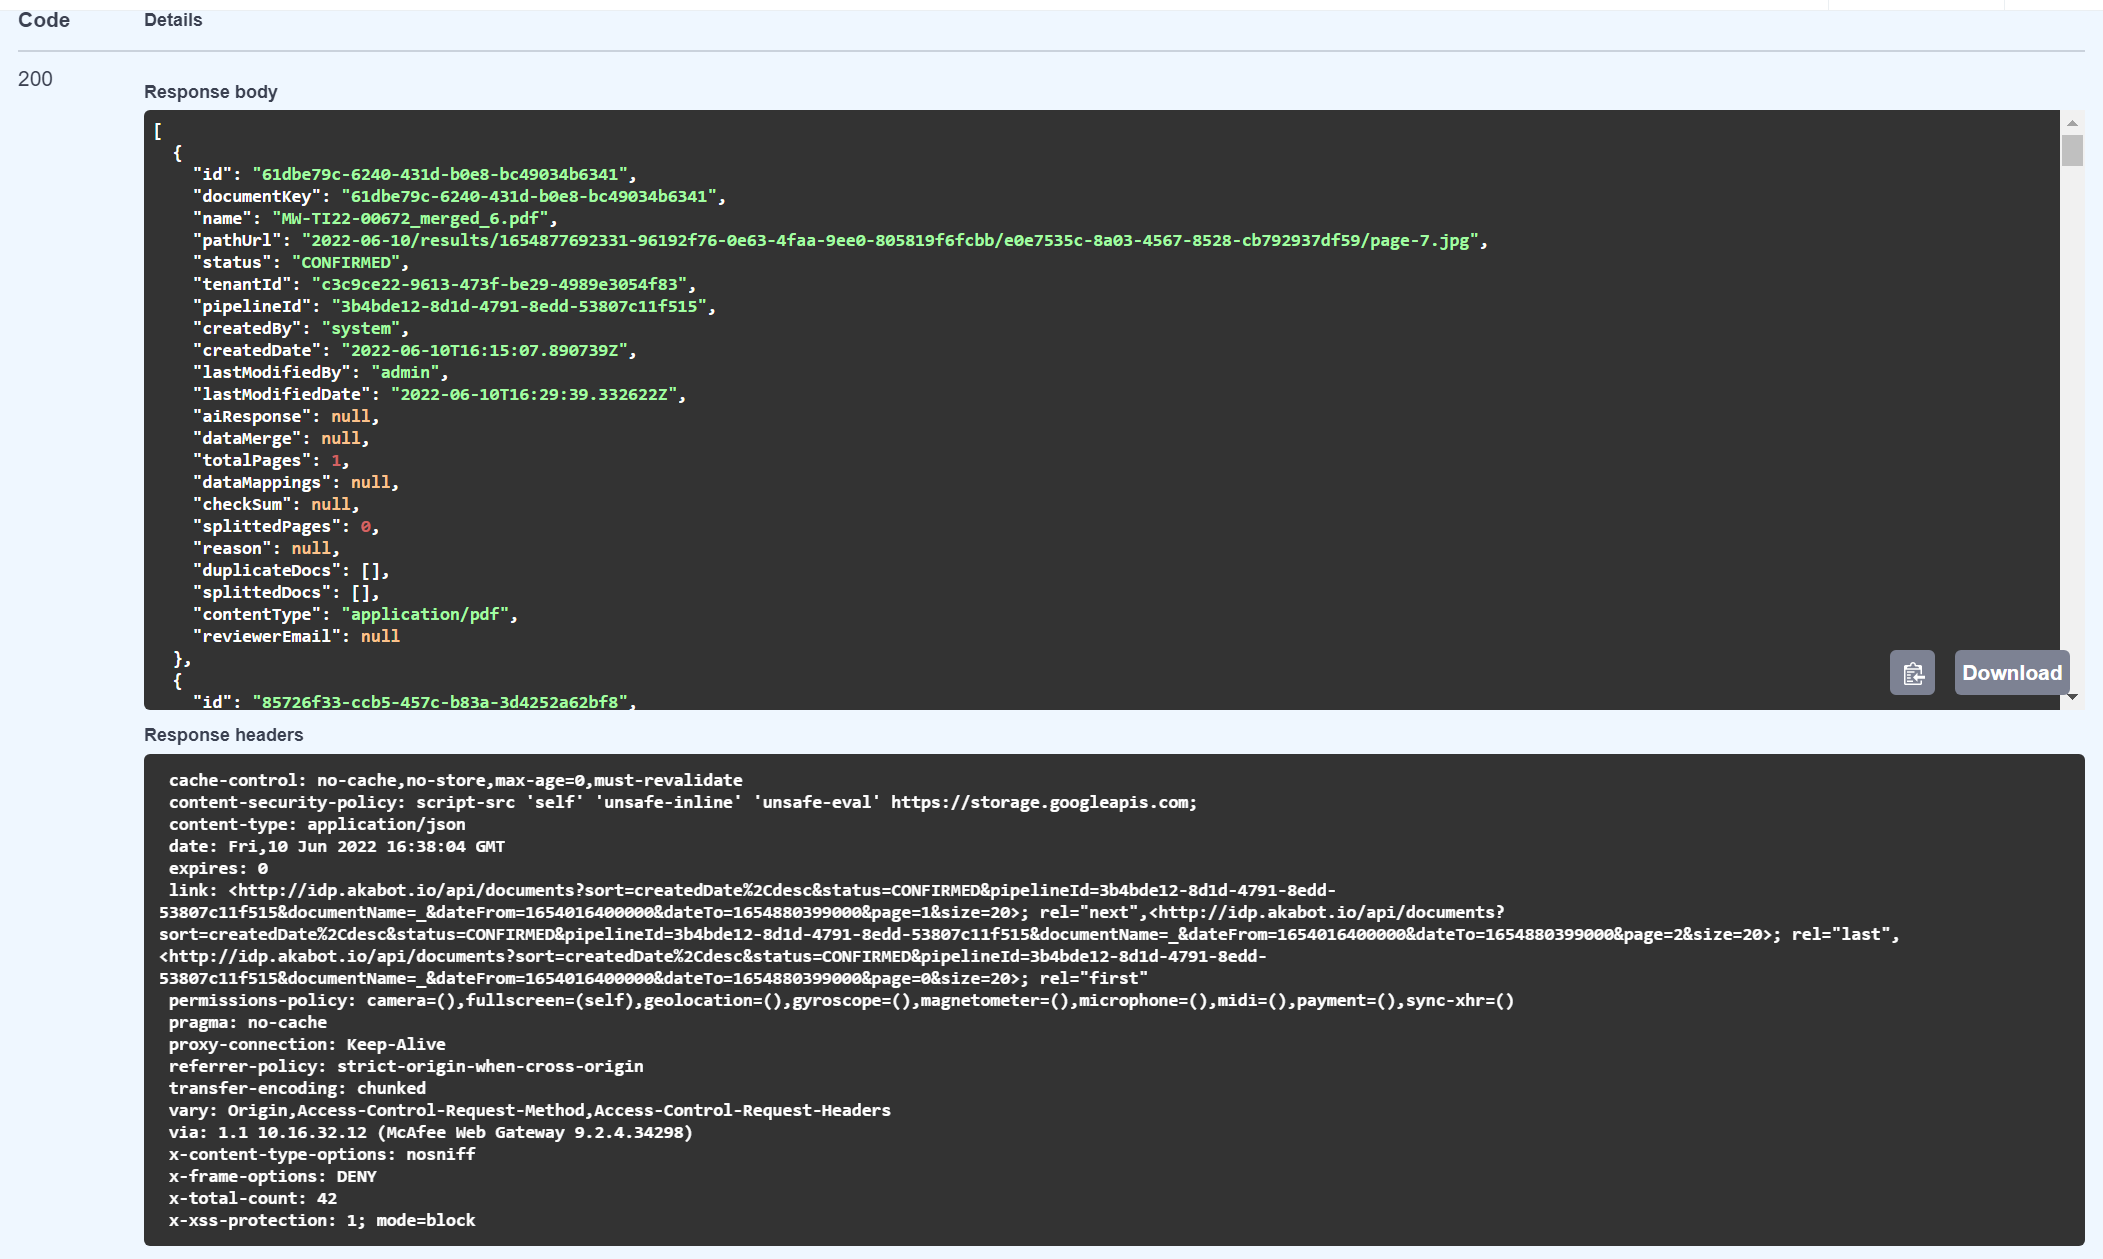
4. 文書ステータスの更新
- 目的: ユーザーは API 経由でドキュメントのステータスを変更できます。ドキュメントのステータスを更新できます。
- URL:
{serverEndpoint}/api/change-docs-status - コンテンツタイプ: application/json
- メソッド: POST
- リクエストヘッダー:
Authorization: Bearer {apiKey} - 入力本文:
| 属性 | タイプ | 説明 | 必須 |
| docId | 文字列配列 | リストドキュメントの ID を更新する必要があるステータス | はい |
| ステータス変更 | 文字列 | ドキュメントが変更されるステータス | はい |
- 出力
- 成功するとコード 200 が返されます
- 失敗した場合は、以下のエラーコードとメッセージコードを返します。
| 応答コード | 説明 |
| 200 | OK |
| 401 | 無許可 |
| 403 | 禁止 |
| 404 | 見つかりません |
応答例:
5. ドキュメントステータスの取得
- 目的: ドキュメントのステータスを取得する
- URL:
{serverEndpoint}/api/documents/{id} - コンテンツタイプ: application/json
- メソッド: GET
- リクエストヘッダー:
Authorization: Bearer {apiKey} - 入力パラメータ:
| 属性 | タイプ | 説明 | 必須 |
| ID | 文字列 | 情報を取得したいドキュメント ID | はい |
- 出力:
成功するとコード 200 が返され、応答はドキュメント モデルになります。
失敗した場合は、以下のエラーコードとメッセージコードを返します。
| 応答コード | 説明 |
| 200 | OK |
| 401 | 無許可 |
| 403 | 禁止 |
| 404 | 見つかりません |
応答例:
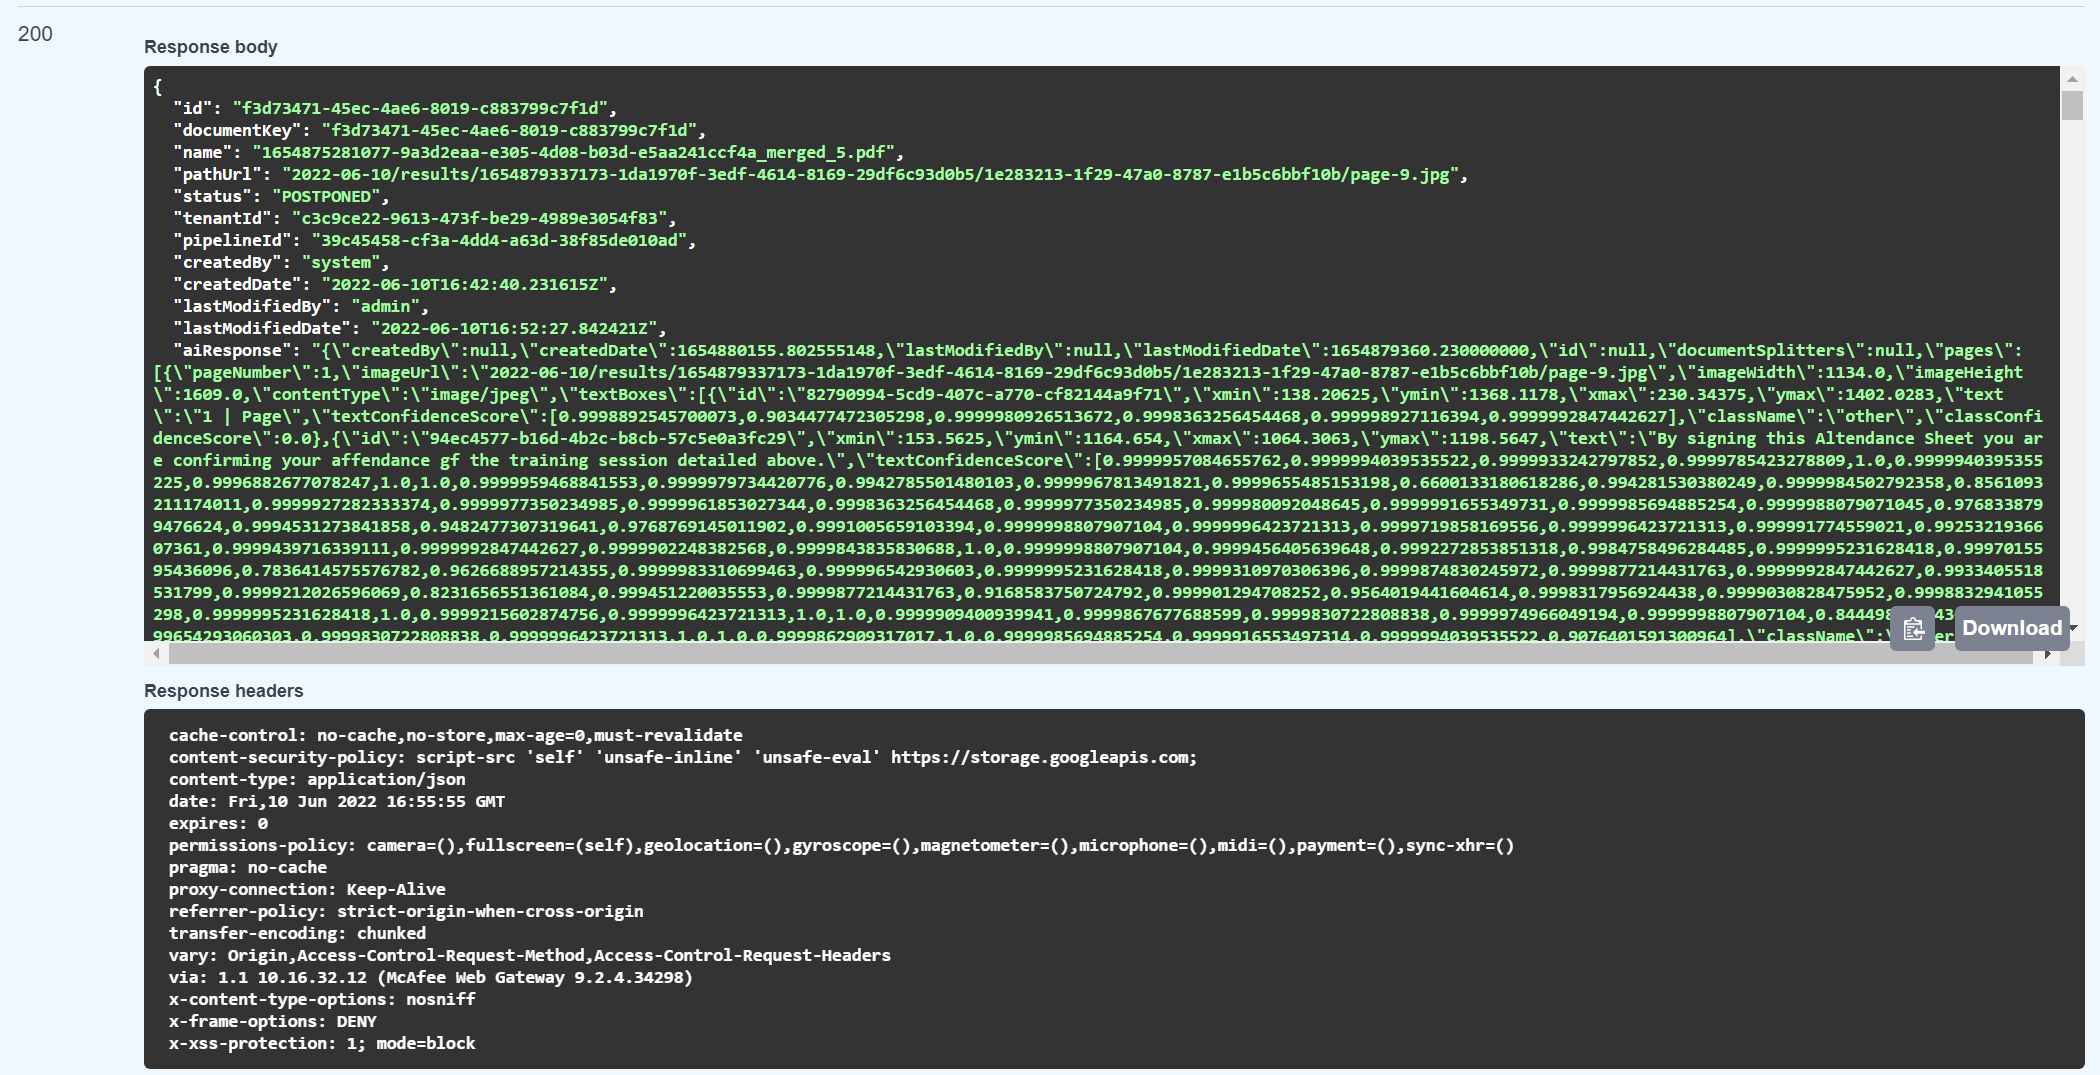
付録
-
サーバーエンドポイント: https://idp.akabot.com/またはhttp://idp.akabot.io
-
API キーを取得: ステップ 1:
{serverEndpoint}/account/api-keysに移動します。 ステップ 2: キーをコピーする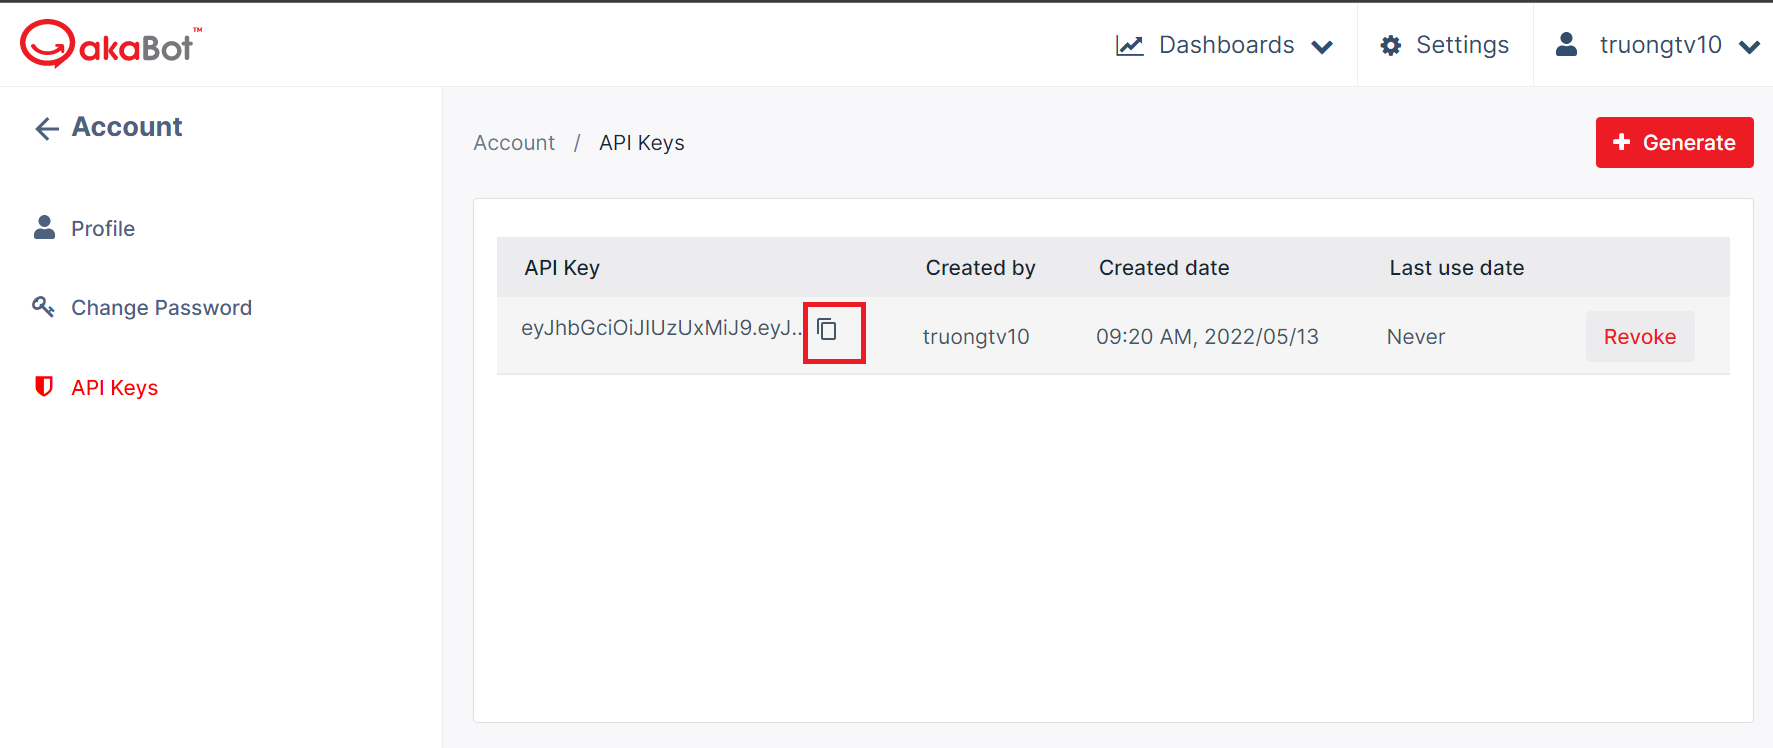
-
ステータスはサポートです:akaBot Docs
-
ドキュメント モデル タイプ:
| 属性 | タイプ | 説明 |
| aiレスポンス | 文字列 | AIから得られる結果 |
| チェックサム | 文字列 | アップロードするドキュメントをリストする |
| コンテンツタイプ | 文字列 | アップロードされたドキュメントの形式 |
| 作成者 | 文字列 | 書類をアップロードする人 |
| 作成日 | 文字列 | 文書のアップロード日 |
| データマッピング | 配列 | |
| データマージ | 文字列 | キャプチャするフィールドと AI の結果の間の結果のマッピング |
| ドキュメントキー | 文字列 | ドキュメントのID |
| 重複ドキュメント | 配列 | リスト ドキュメントは最近アップロードされたドキュメントに複製されます Id: 重複ドキュメントの ID Name: 重複ドキュメントの名前 Status: 重複ドキュメントのステータス |
| ID | ドキュメントのID | |
| 最終更新者 | 文字列 | ドキュメントを最後に変更した人 |
| 最終更新日 | 日時 | ドキュメントが最後に変更された日付 |
| 名前 | 文字列 | 文書の名前 |
| パスURL | 文字列 | ドキュメントのURL |
| パイプラインID | 文字列 | パイプラインのID |
| 理由 | 文字列 | 書類を拒否した理由 |
| 査読者メール | 文字列 | 文書をレビューする人に電子メールを送信する |
| 分割ドキュメント | 配列 | 分割後の文書の一覧表示 |
| 分割ページ | 番号 | 分割後の文書のページ数 |
| ステータス | 文字列 | 書類のステータス |
| テナントID | 文字列 | テナントのID |
| 合計ページ数 | 文字列 | 書類の総ページ数 |